Genesys Cloud Audio Connector
- Tipo de canal: Voz.
- Visibilidad del canal: No aplica.
- Complejidad de integración: Alta (requiere proveedores externos de Text-to-Speech y Speech-to-Text, además de la cuenta de Genesys Cloud).
- Chat general o solo Kyubo: No aplica (canal de voz, sin interfaz de chat).
- Sandbox disponible: N/D.
Definición
Este canal permite la comunicación entre Lynn y el servicio de voz de Genesys Cloud, utilizando mecanismos de conversión de voz a texto (Speech-to-Text) y de texto a voz (Text-to-Speech) para habilitar una experiencia conversacional completa. Mientras Genesys gestiona el audio, Lynn interpreta y responde mediante texto procesado, por lo que el diseño del IVR puede realizarse directamente desde Lynn.
Pre-requisitos
Text-to-Speech — ElevenLabs
- Cuenta activa en ElevenLabs.
- Clave API (API Key) válida: iniciar sesión → "My Account" → "API Keys" → "Create API Key".
Important
La clave completa solo se muestra una vez, en el momento de su creación. Debe copiarse y guardarse en un lugar seguro; posteriormente solo son visibles los últimos cuatro caracteres.
- Voz configurada en la cuenta (obtener el Voice ID desde el panel de ElevenLabs).
- Formato de salida compatible (mp3, wav).
- (Opcional) Configuración de idioma, estilo o parámetros de voz según el flujo.
Speech-to-Text — Azure Speech Services
Cuenta activa en Microsoft Azure.
Servicio de Speech creado en el portal de Azure.
Claves necesarias: Speech API Key (portal Azure → recurso Speech Service → "Keys and Endpoint") y Región del recurso (ej.
eastus).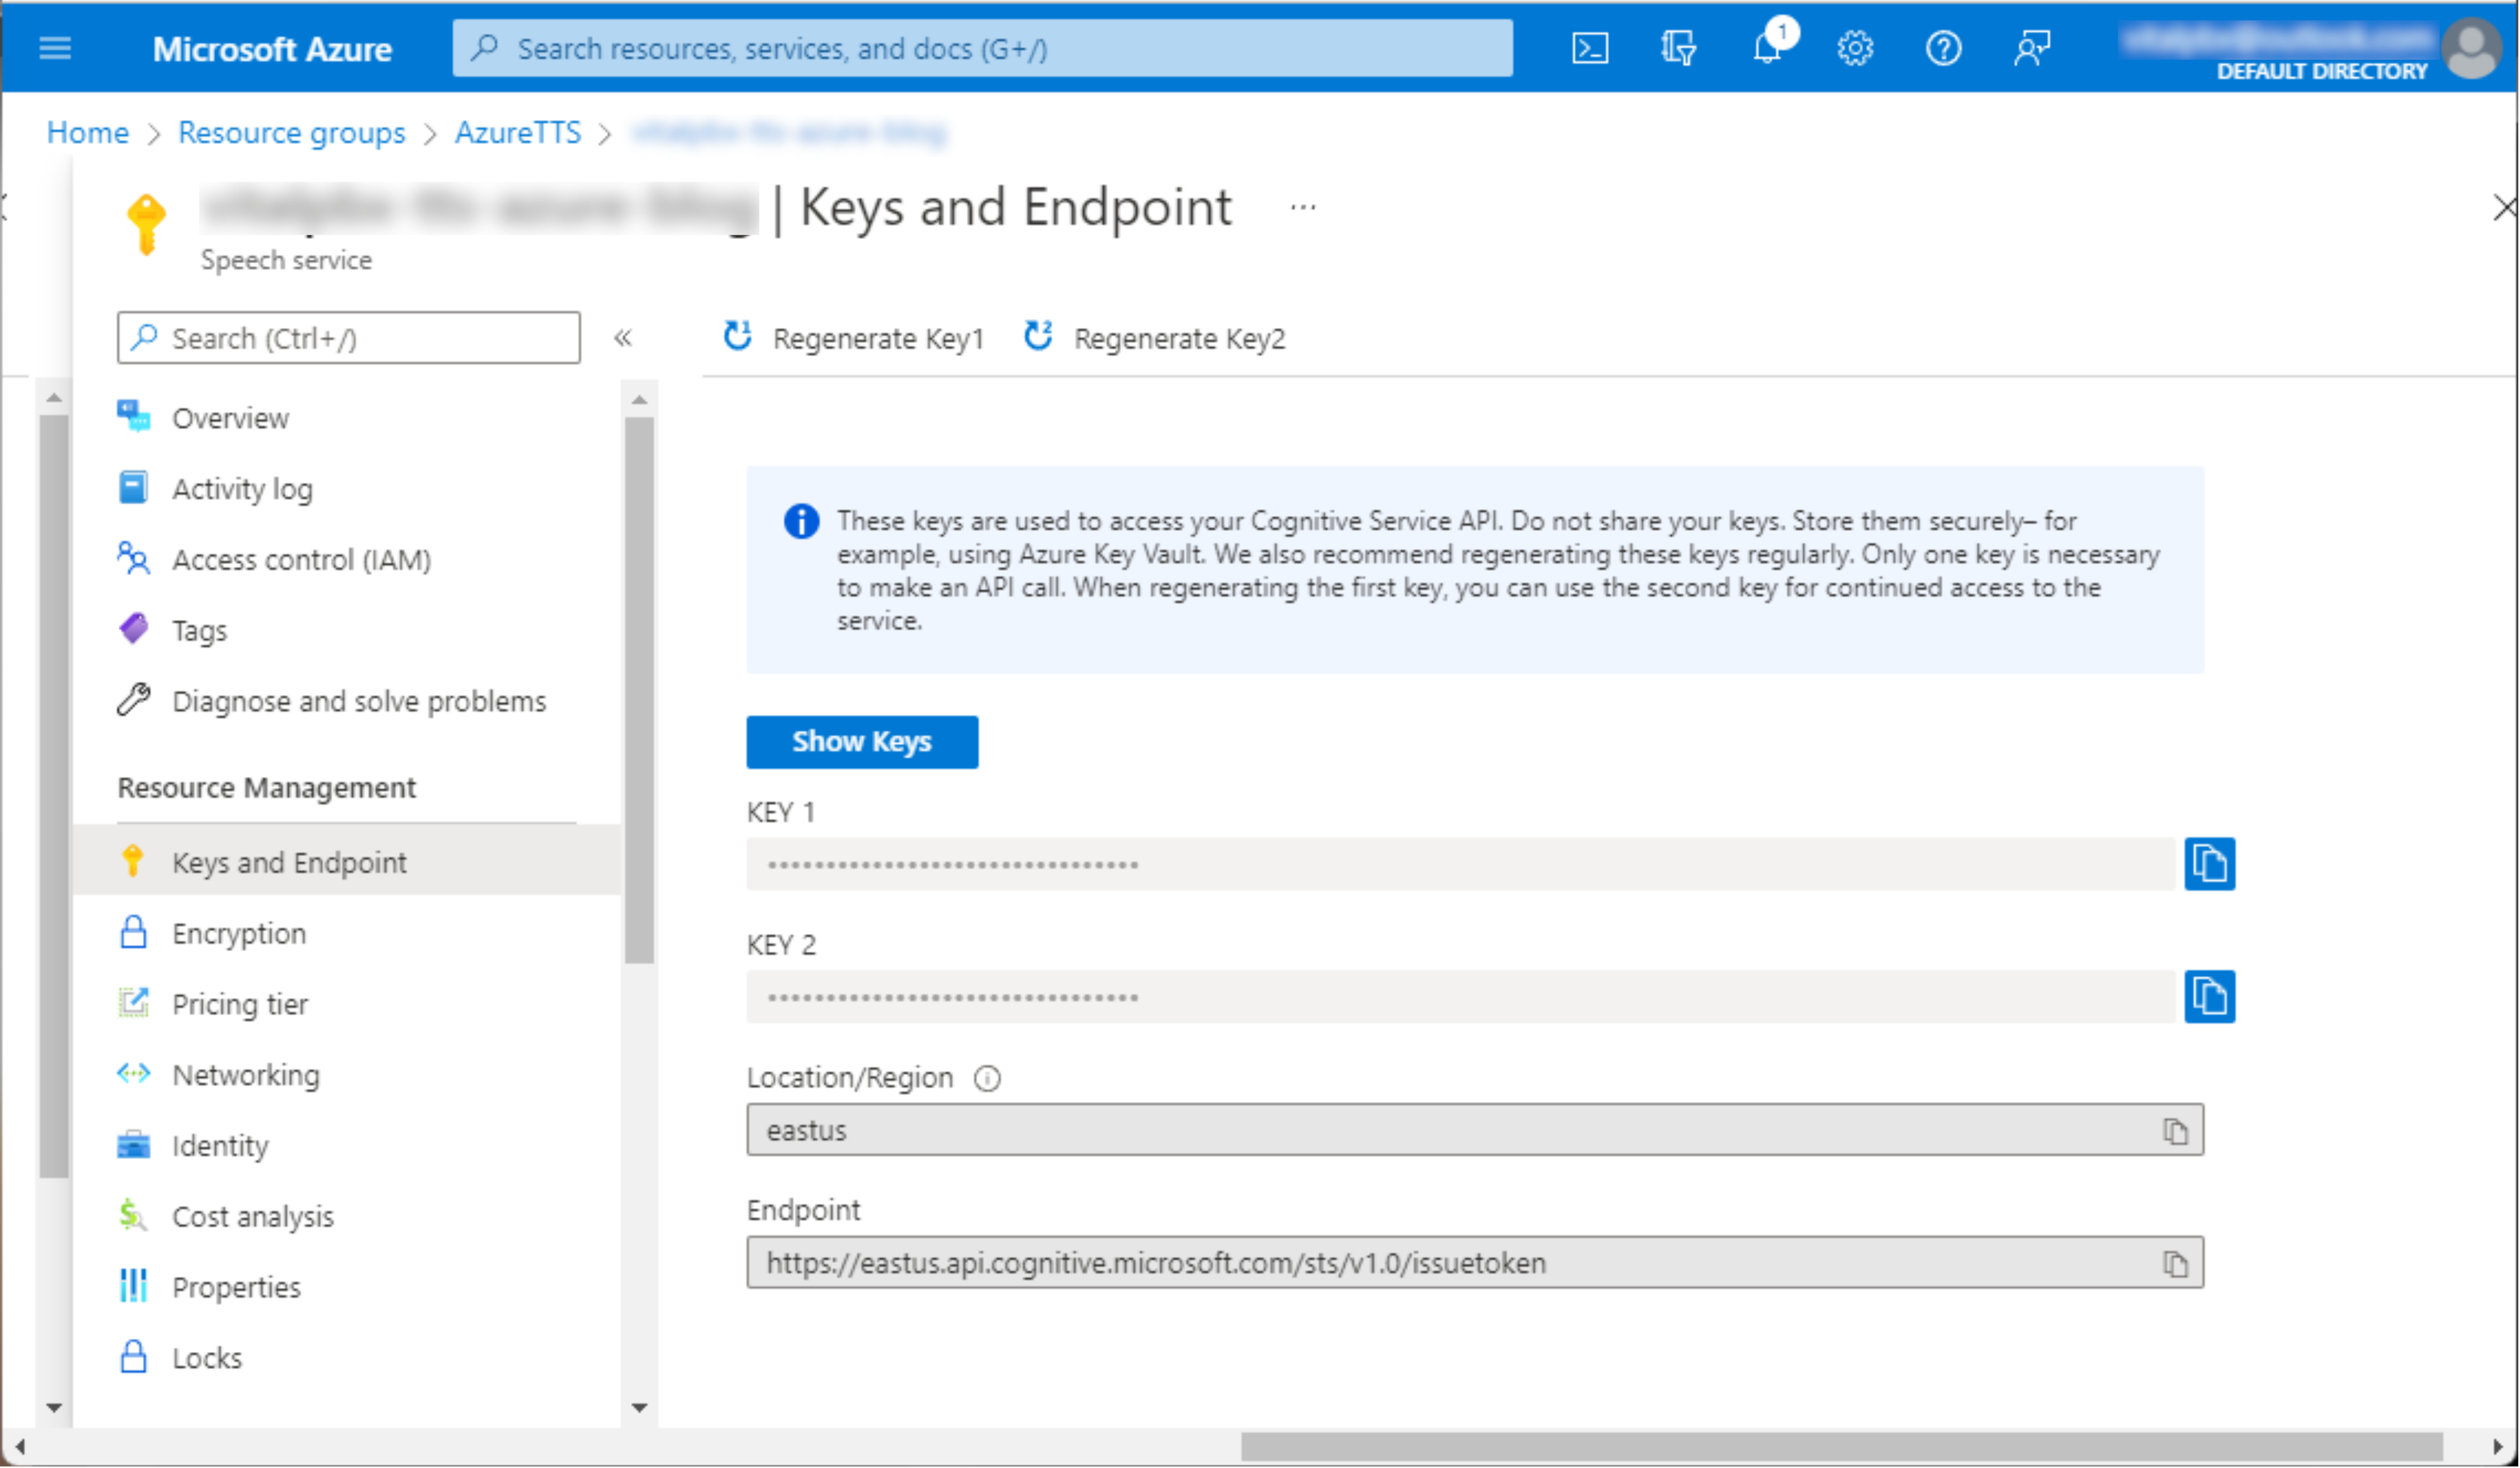
Idioma configurado para el reconocimiento de voz (ej.
es-ES,en-US).Permisos habilitados para consumir el endpoint de Speech-to-Text.
Verificar que el formato de audio enviado sea compatible (ej. PCM 16 kHz, mono).
Pasos para la creación del canal
Iniciar sesión en Lynn.
Seleccionar "Diseñador" en el menú lateral izquierdo.
Clic derecho sobre el área libre del diseñador → "Configurar canal" → "Agregar canal a [Ambiente]".
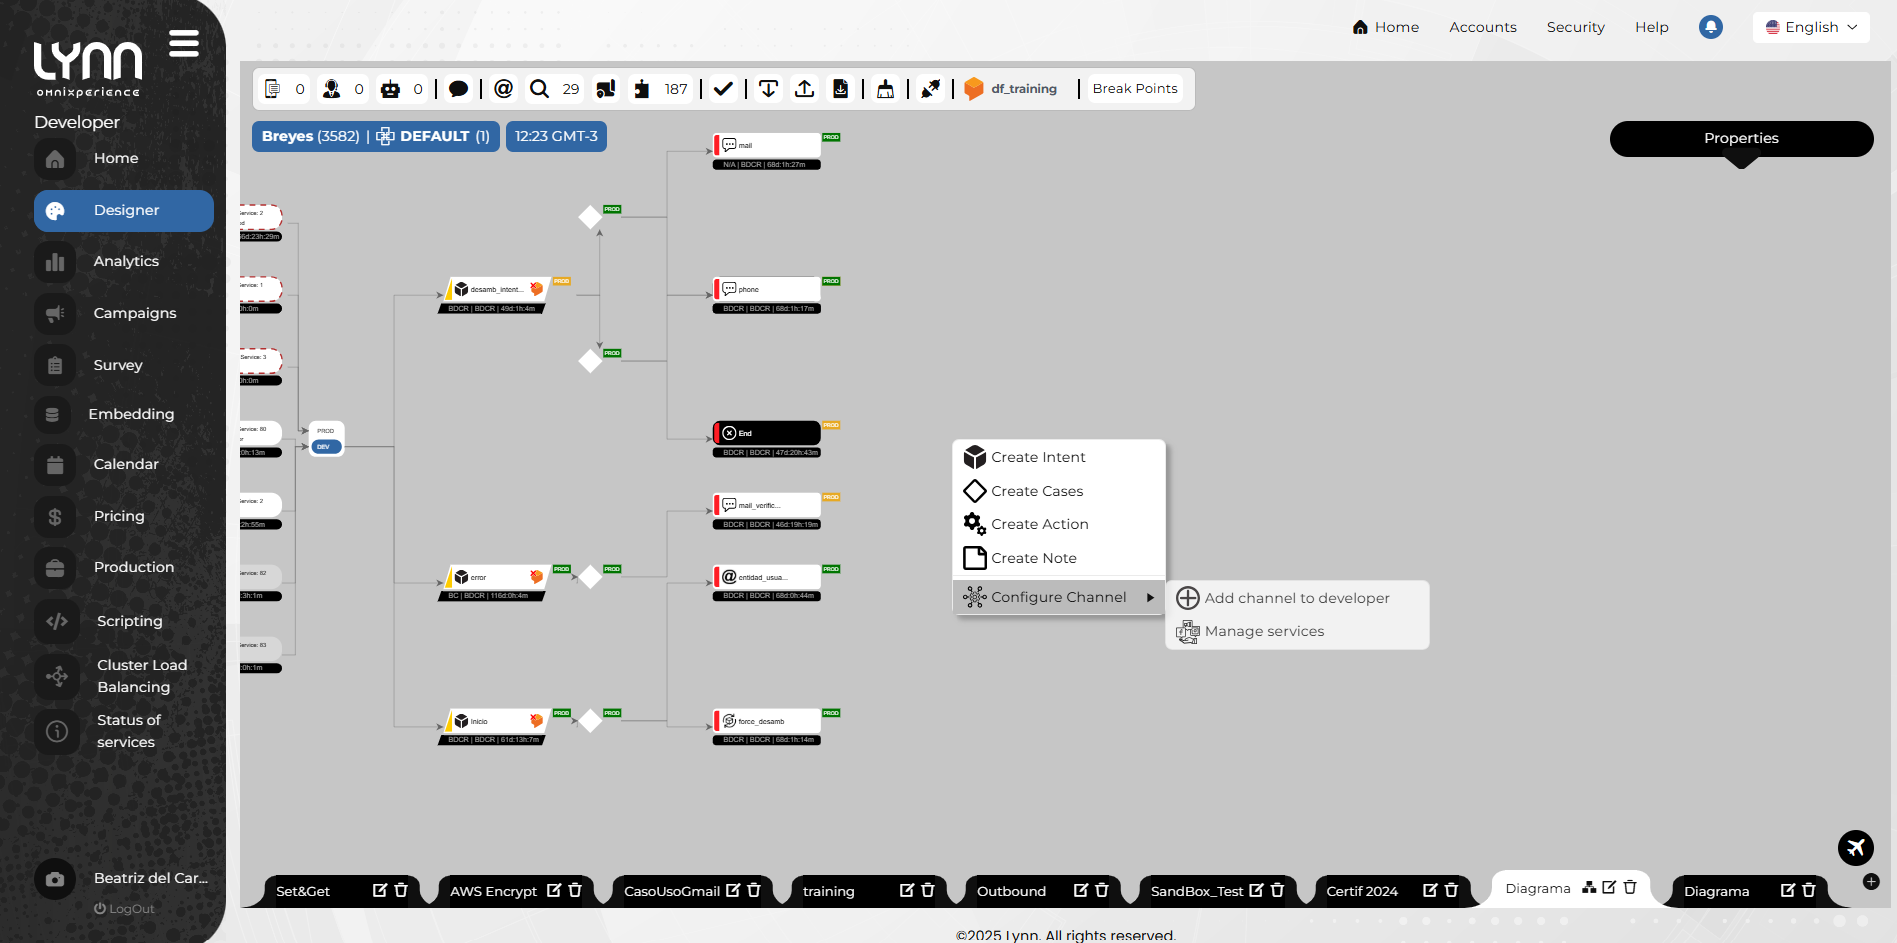
Elegir Genesys Cloud Audio Connector → "Crear".
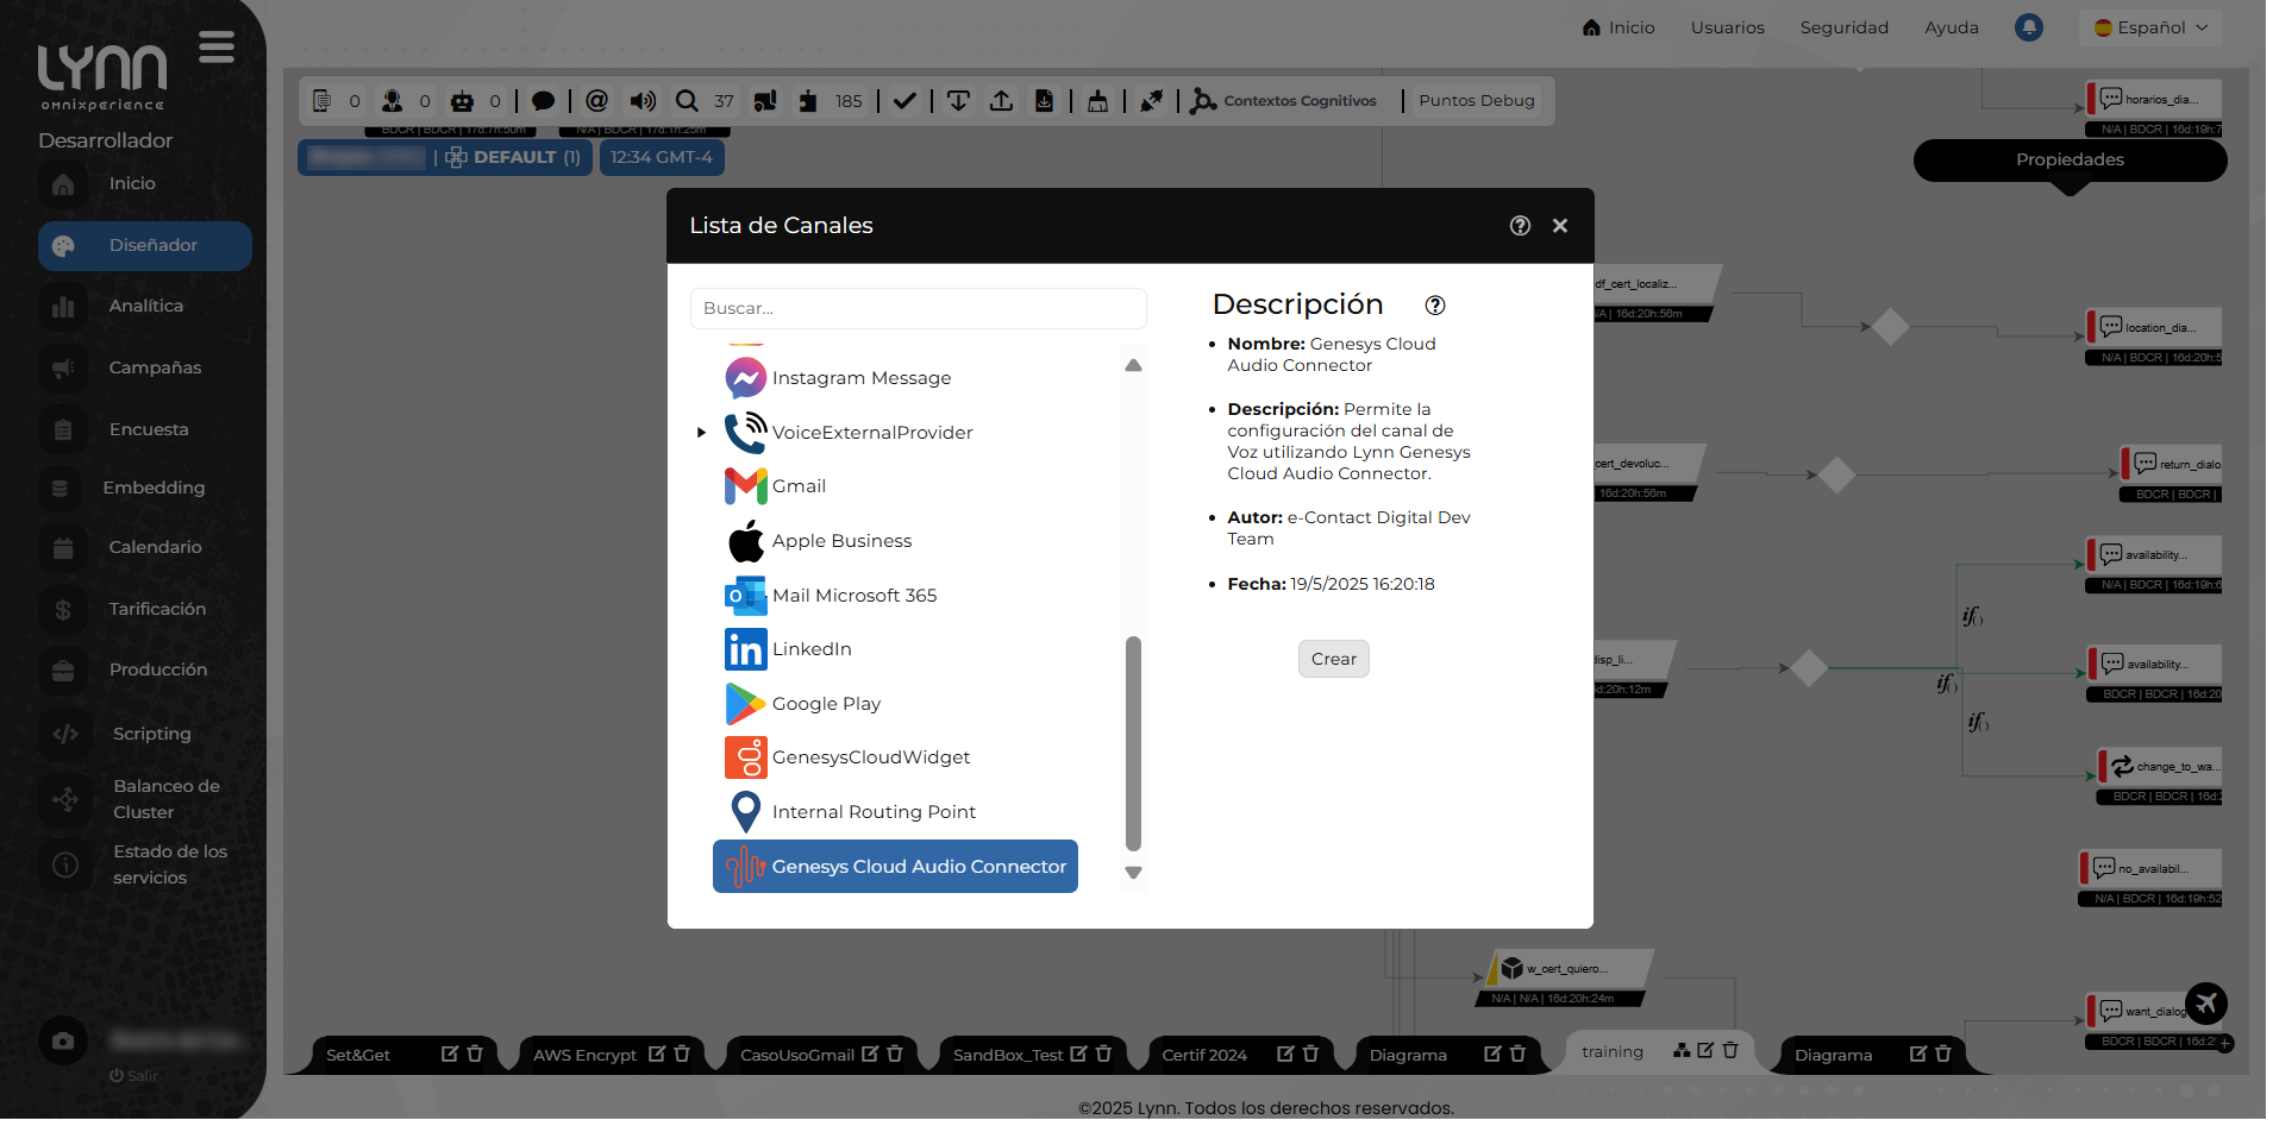
Hacer clic en "Verificar" y luego en "Crear". El sistema confirma la creación exitosa del canal.
Activar el canal: clic derecho sobre la burbuja del canal → "Activar".
Campos de configuración del canal
Proveedor Text-to-Speech
| Parámetro | Descripción |
|---|---|
TTS_PROVIDER |
Proveedor del servicio TTS. Actualmente, el único proveedor disponible es ElevenLabs. |
TTS_CREDENTIALS |
API Key de ElevenLabs. Cuenta con validación inmediata (ícono verde si es correcta, ícono rojo si falla). |
TTS_VOICE |
Una de las voces habilitadas en la cuenta de ElevenLabs. |
TTS_VOICE_SETTINGS |
Sección de ajustes de la voz (todos los campos numéricos entre 0 y 1): Stability (consistencia emocional; por defecto 0.5), Similarity Boost (fidelidad respecto a la voz original; por defecto 0.75), Style (amplificación del estilo del hablante; por defecto 0.0), Use Speaker Boost (refuerzo de identidad vocal; por defecto false), Speed (velocidad de reproducción; por defecto 1.0, mínimo recomendado 0.7, máximo permitido 1.2), Model (modelo de síntesis de voz). |
Proveedor Speech-to-Text
| Parámetro | Descripción |
|---|---|
STT_PROVIDER |
Motor STT a utilizar. Actualmente, el único proveedor disponible es Azure. |
STT_CREDENTIALS |
Sección con Endpoint (URL base del servicio de Azure Speech), SubscriptionKey (clave de suscripción del recurso) y Region (región geográfica del servicio, ej. eastus). |
| Language | Código de idioma del audio a reconocer (ej. es-ES, en-US). |
Parámetros funcionales
- Tiempo de inactividad para finalizar la interacción (ms): tiempo máximo sin entrada de voz antes de que Lynn cierre automáticamente la interacción.
- Tiempo de espera antes de comenzar el reconocimiento de voz (seg): retardo inicial antes de activar el reconocimiento, para evitar captar sonidos irrelevantes o solapamientos.
- Diálogos aleatorios durante la creación de sesión: lista de frases que se ejecutan aleatoriamente mientras se inicializa el asistente virtual.
- Intención a ejecutar cuando ocurre un silencio.
- Intención a ejecutar cuando el cliente interrumpe el mensaje.
- Intención a ejecutar cuando ocurre un error (fallos del motor STT o problemas de conexión).
- Tamaño del buffer de audio enviado al proveedor STT (seg).
- Permitir interrupciones por voz: habilita que el usuario interrumpa mensajes hablados de Lynn.
- Umbral de silencio (seg): tiempo de silencio consecutivo interpretado como fin de una frase.